AIsferatu: il principe dei dati
Come i vampiri dei romanzi, le aziende dell’AI hanno bisogno di sangue fresco: dati nuovi per nutrirsi ed evolvere. Ma chi decide come si accede a quei dati e a che prezzo?

Usare opere protette per addestrare modelli è consentito
Il 3 novembre Maciej Szpunar, avvocato generale della Corte di giustizia dell’Unione europea, ha presentato le sue conclusioni nella causa fra Google e Like Company, una società ungherese che pubblica siti di notizie e accusa Gemini, il chatbot di Google, di riproporre i suoi articoli.
Secondo Szpunar, usare opere protette per addestrare un modello linguistico è «di norma, liberamente consentito». Il diritto dell’editore è violato solo quando i suoi articoli sono riconoscibili nelle risposte del chatbot (1).
Sull’addestramento, però, Szpunar si esprime solo a margine: considera ipotetiche le domande del giudice ungherese su quel punto e propone alla Corte di non rispondere, e la frase sull’addestramento la scrive «per completezza». Le conclusioni non sono una sentenza. Dicono però dove siamo arrivati: in Europa, buona parte di quello che le aziende dell’AI hanno preso per addestrare i loro modelli era permesso.
In Matrix, il film del 1999, le macchine usano gli esseri umani per produrre energia elettrica, mentre una simulazione del mondo li tiene tranquilli. Quello che viviamo oggi ha qualche analogia se scambiamo l’elettricità con i dati: le macchine estraggono i dati, che gli forniamo spesso senza farci caso, ogni volta che scriviamo qualcosa in rete o facciamo una domanda a un chatbot.
Quasi tutto il web pubblico è materia prima già estratta, è già al sicuro nelle capaci «cisterne» dei modelli AI. Ma le regole per i dati che verranno si possono scrivere adesso.
Perché quei dati producono soldi e ne produrranno ancora di più domani, quando verranno usati per creare robot in grado di sostituire l’uomo anche nei lavori manuali. È quindi eticamente ed economicamente corretto che le materie prime vengano pagate.
Questa edizione prova a rispondere a sei domande. Perché si parla di giacimenti di dati, e perché contano tanto? Cosa sono le raffinerie di dati? Chi ha estratto ha pagato qualcosa? Dove trovano i modelli i dati freschi di cui hanno bisogno? Che cosa stanno facendo gli Stati? E che cosa possiamo fare noi?
Perché si parla di giacimenti
La prima domanda è perché si parli di giacimenti, e perché siano così importanti.
La parola viene dalle miniere: un giacimento è un luogo ricco di una risorsa, e chi ottiene il permesso di scavarlo diventa proprietario di quello che estrae. Con i dati succede lo stesso. Il permesso, però, lo dà quasi sempre la legge o un clic su «Accetta». Chi i dati li ha prodotti spesso non sa nemmeno di averlo concesso.
I giacimenti non sono tutti uguali. Il web pubblico è stato scavato quasi per intero negli ultimi anni. Restano i cataloghi degli editori e le piattaforme su cui pubblichiamo. Ci finisce anche Substack, la piattaforma da cui esce questa newsletter: Common Crawl, l’archivio del web da cui partono quasi tutti i dati di addestramento, a dicembre 2025 ne ha raccolto decine di migliaia di pagine in un solo passaggio. Gli autori hanno un interruttore che dice agli strumenti di AI di non addestrarsi sui loro testi, ma vale solo per chi decide di rispettarlo.
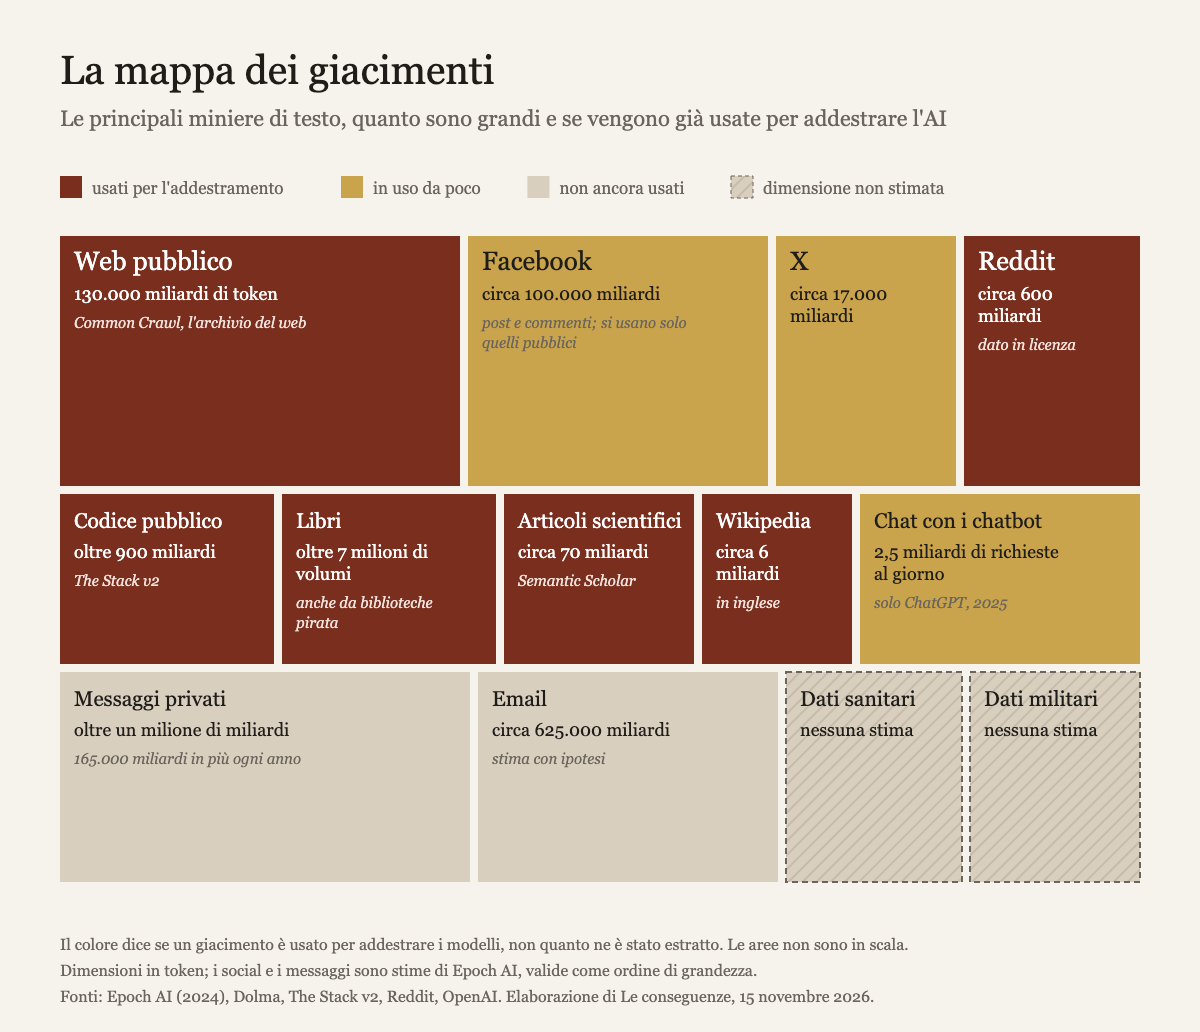
Il giacimento più recente, quello che si riempie ogni giorno, sono le conversazioni con i chatbot. Agli estremi ce ne sono due che pesano più degli altri: i dati sanitari, che possono servire a curare, e quelli raccolti per fare la guerra.
I dati sono fondamentali per i modelli AI, sono più importanti della benzina per le automobili. Per continuare la metafora automobilistica, i dati per l’AI sono come i materiali di cui sono fatte le automobili stesse. Senza dati non esisterebbero proprio i modelli. E dai dati dipende quello che un modello sa fare, al punto che si può copiare un modello raccogliendo le sue risposte.
A settembre Anthropic, l’azienda che produce Claude, ha accusato sette laboratori con sede in Cina di aver copiato il suo modello usando reti di account falsi e spendendo «una frazione» del tempo e del calcolo che sarebbero serviti per arrivarci da soli (2). È l’accusa di una parte in causa.
Il valore dei dati si misura anche con un prezzo: nel giugno 2025 Meta ha pagato 14,3 miliardi di dollari per il 49% di Scale AI, un’azienda che non costruisce modelli ma prepara i dati per addestrarli.
Le raffinerie
La seconda domanda è che cosa siano le raffinerie di dati.
Chiamo così tutte le aziende che trasformano il greggio dei giacimenti in materiale per addestrare i modelli: chi produce i dati, chi li compra e chi li prende senza chiedere. Una parte della raffinazione la fanno in casa i laboratori stessi, come OpenAI, Google, Meta e Anthropic. Il resto lo fanno aziende meno note, che producono dati su ordinazione: reclutano persone in tutto il mondo, dagli studenti ai medici, che scrivono domande e risposte, correggono quelle dei modelli e ne giudicano la qualità.
Il nome è mio. Il settore le chiama aziende di etichettatura dei dati (data labeling) o di «dati umani» (human data), e Scale AI, la più grande, …si presenta come la fonderia dei dati per l’AI. Per la metafora dell’automobile la sua parola sarebbe più giusta, perché i dati sono i metalli, non la benzina; ma accanto a giacimenti, raffinerie si capisce subito.
Sono cresciute in pochi anni, e la tabella in basso mette in fila le principali: le più grandi fatturano già più di un miliardo di dollari l’anno. Sono quasi tutte americane, come i laboratori che comprano i loro dati. Le europee sono piccole: la britannica Prolific, la più solida, ha fatturato 28,6 milioni di sterline nel 2025, una frazione di Scale AI; Toloka, ad Amsterdam, lavora per Amazon, Anthropic e Microsoft ma non pubblica i ricavi.
In fondo alla filiera ci sono i lavoratori pagati meno. Nel 2023 un’inchiesta di TIME ha raccontato che Sama, un’azienda di San Francisco, pagava fra 1,32 e 2 dollari l’ora i lavoratori in Kenya che leggevano ed etichettavano testi violenti, per insegnare a ChatGPT a riconoscerli; OpenAI pagava a Sama 12,50 dollari per ogni ora di quel lavoro (3).
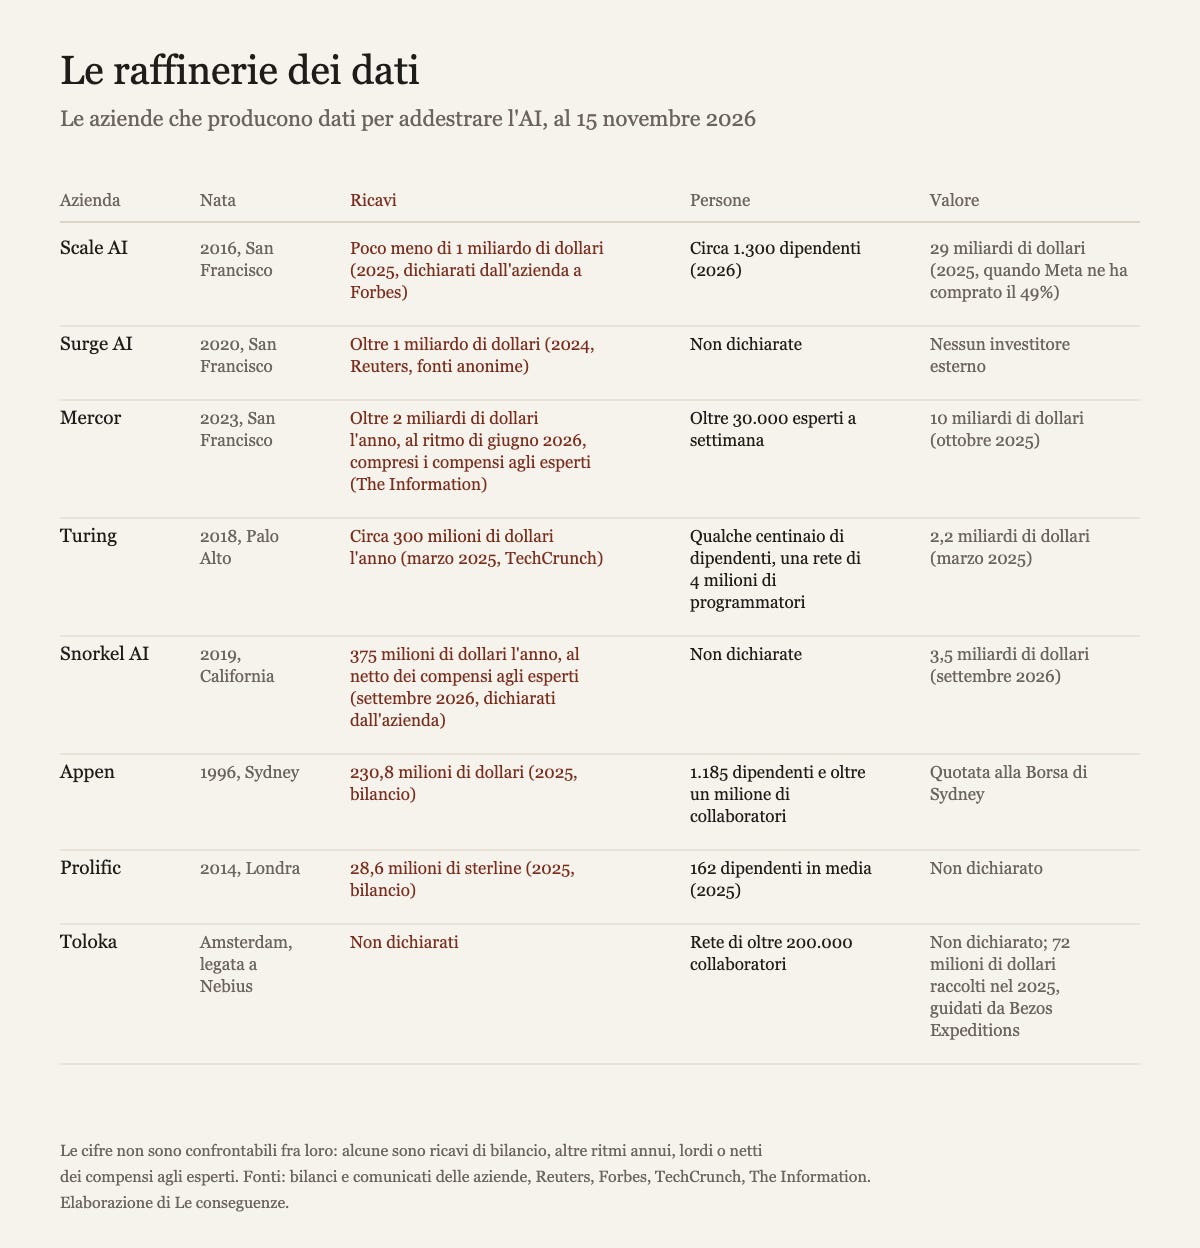
In questa filiera pagano quasi tutti: i laboratori pagano le raffinerie, le raffinerie pagano gli esperti. Chi ha prodotto il greggio, scrivendo il web, non riceve niente.
Chi ha estratto ha pagato qualcosa?
La terza domanda è se le aziende AI hanno pagato qualcosa per fare le loro estrazioni.
Hanno preso quasi tutto quello che potevano raggiungere gratuitamente. Una parte era libera per definizione: le opere uscite dal diritto d’autore, come i libri di autori morti da più di settant’anni, e i testi pubblicati con licenze aperte, come Wikipedia e gran parte del codice su GitHub, che chiedono di citare la fonte e poco altro. In Europa, poi, gli enti di ricerca possono sempre estrarre testi e dati per la ricerca scientifica.
Quando hanno dovuto pagare, il motivo è stato quasi sempre il modo in cui lo avevano preso: libri scaricati da biblioteche pirata, oppure dati personali trattati senza una base giuridica. Anthropic ha chiuso la causa degli autori americani con 1,5 miliardi di dollari, circa 3.000 per libro, come abbiamo raccontato nel n. 8. In Francia Google ha pagato 250 milioni di euro all’Autorità della concorrenza, anche perché aveva usato i contenuti di editori e agenzie per il suo chatbot senza dirlo e senza offrire un modo per opporsi.
Per avere usato le opere nell’addestramento, invece, quasi nessuno ha pagato: i giudici e le leggi lo hanno considerato lecito quasi ovunque. Nel giugno 2025 un giudice federale americano ha stabilito che addestrare un modello sui libri comprati rientra nel «fair use», l’uso lecito che il diritto americano ammette quando un’opera viene trasformata in qualcosa di nuovo. Due giorni dopo un altro giudice ha dato ragione a Meta, che aveva scaricato libri da archivi pirata, precisando che gli autori avevano sbagliato argomenti. In Europa la direttiva sul diritto d’autore del 2019 permette l’addestramento finché il titolare non si oppone, e il garante irlandese della privacy, dopo aver chiesto alcune modifiche, non ha fermato Meta quando il 27 maggio 2025 ha cominciato ad addestrare i suoi modelli sui post pubblici degli europei.
Lecito, però, non vuol dire giusto. Chi compra un libro compra una copia, non l’opera: può leggerlo, prestarlo, rivenderlo, ma per farne un film deve comprare dall’autore i diritti, che si pagano a parte. La domanda è se addestrare un modello somigli alla lettura o al film. Le aziende dicono lettura, e finora i giudici le hanno seguite. Gli autori dicono film, perché un modello addestrato sui romanzi di uno scrittore può scriverne altri che si vendono al posto dei suoi: il giudice del caso Meta ha dato torto agli autori proprio perché non avevano portato prove di questa concorrenza. E la gran parte dei dati non è mai stata comprata: il web si legge gratis, ma nessuno lo ha ceduto.
In Italia è caduta anche una multa per la privacy. Il Garante aveva multato OpenAI per 15 milioni di euro nel dicembre 2024. A marzo il Tribunale di Roma l’ha annullata: a decidere doveva essere il garante irlandese.
Dove serve il consenso, il consenso è disegnato per arrivare in fretta. Quando nell’agosto 2025 Anthropic ha chiesto agli utenti di Claude se lasciare le loro conversazioni all’addestramento, la schermata aveva un pulsante «Accept» nero e ben visibile e, sotto, un interruttore molto più piccolo, già acceso (4). Chi accettava lasciava anche che le chat venissero conservate per cinque anni.
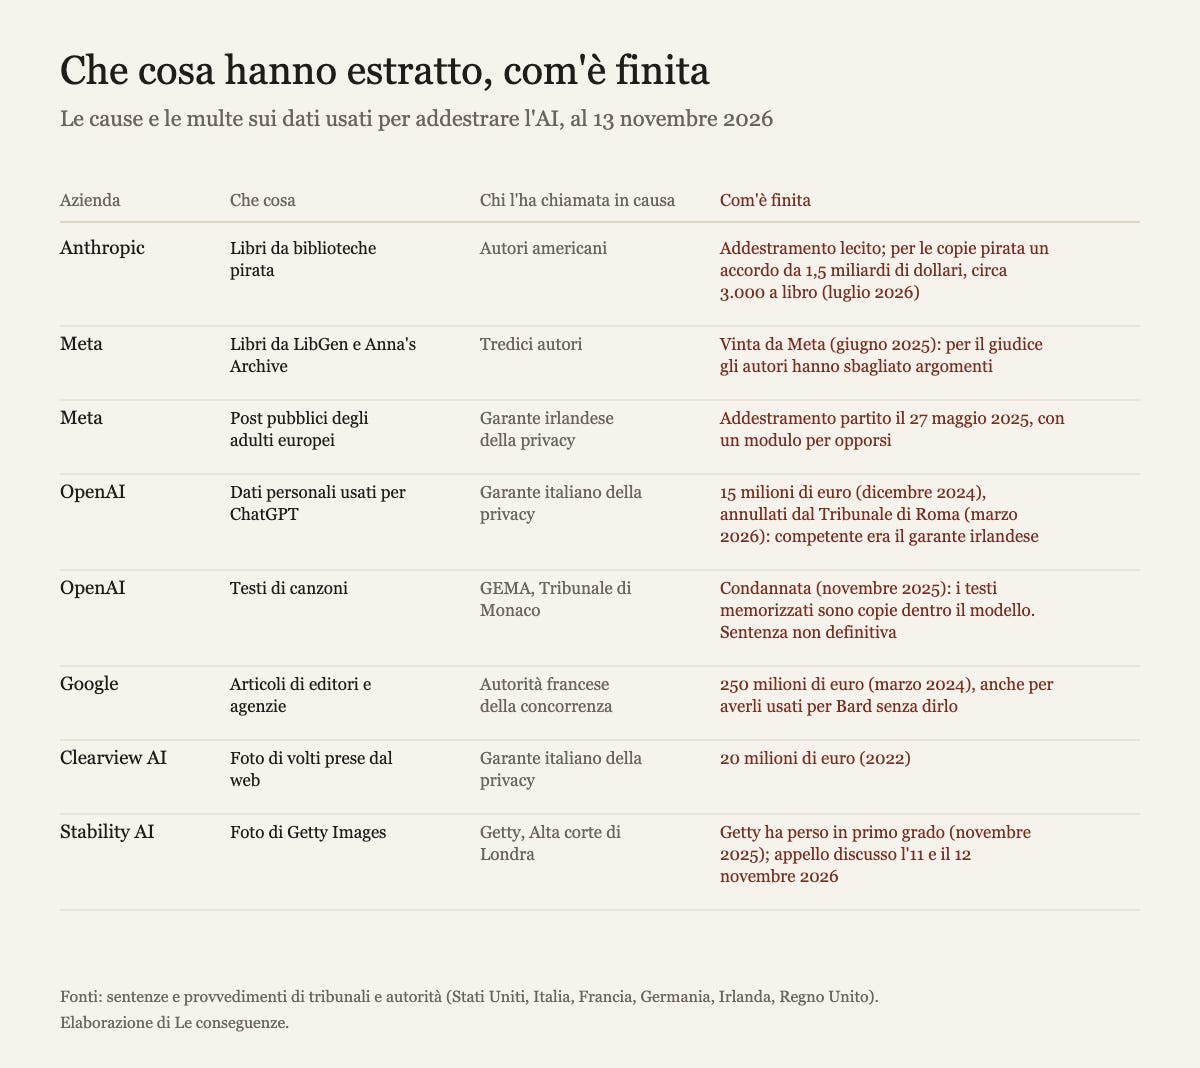
Penso che la risposta alla terza domanda sia questa: le aziende hanno pagato quando avevano preso i dati in modo illecito, scaricando libri pirata o trattando dati personali senza una base giuridica, e quasi mai per averli usati nell’addestramento. Lo scandalo, in gran parte, era legale. Ma la velocità del fenomeno da una parte, e la lentezza e la scarsa competenza di chi doveva scrivere le regole dall’altra, hanno permesso ai laboratori AI di saccheggiare il lavoro di milioni di persone.
Il problema dei dati freschi
La quarta domanda riguarda i dati freschi, cioè quelli che i modelli non hanno ancora visto.
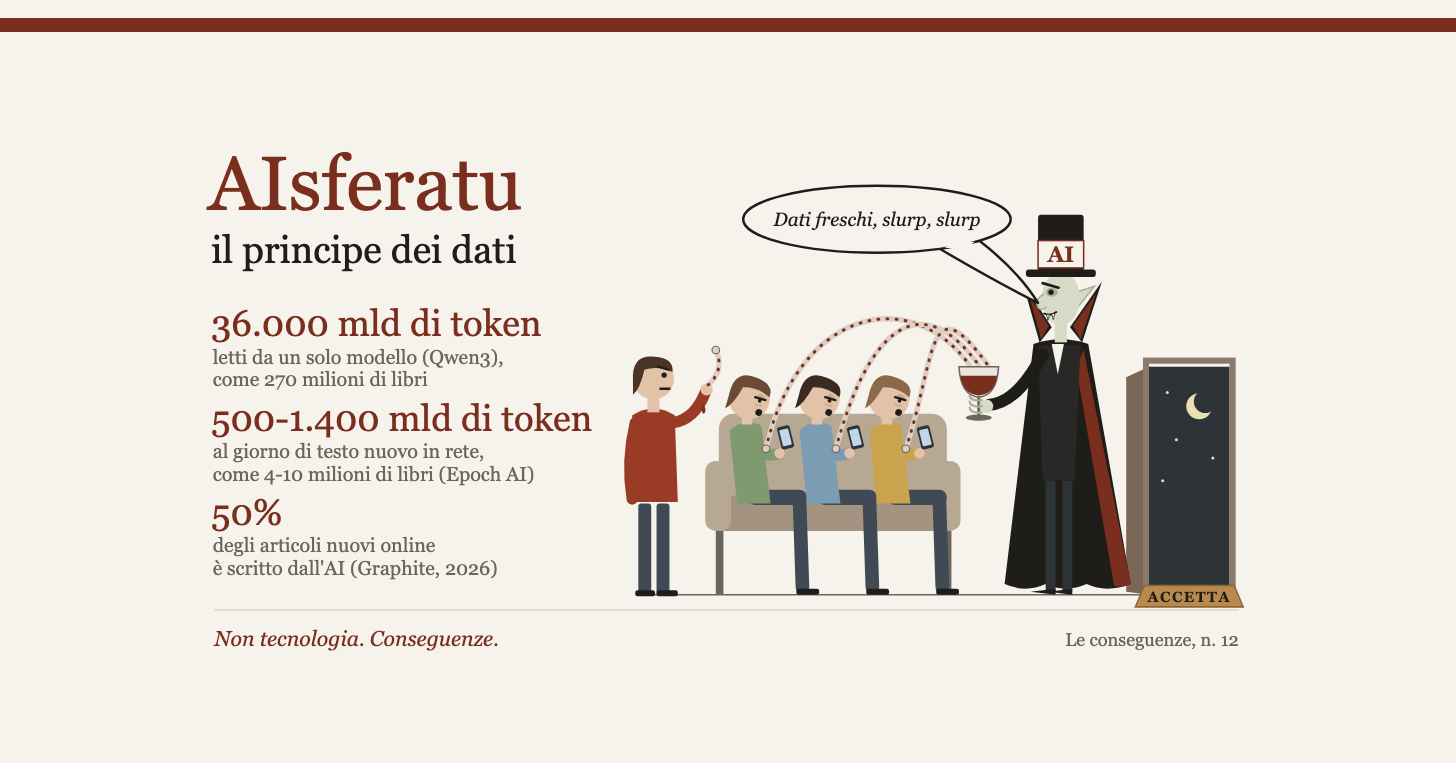
Servono perché finora i modelli sono migliorati soprattutto crescendo, con più calcolo e più testo, e il testo scritto da persone sta finendo. Epoch AI, un istituto di ricerca che studia l’andamento dell’intelligenza artificiale, stima che il testo pubblico di buona qualità ammonti a circa 300.000 miliardi di «token», i frammenti di parola con cui i modelli leggono, e che fra il 2026 e il 2032 i modelli più grandi ne useranno quanto ne esiste (5). Il 2026 è il primo anno di quella finestra. Il giacimento si riempie ancora: secondo la stessa Epoch, in rete finiscono ogni giorno fra 500 e 1.400 miliardi di token di testo nuovo, tanto testo quanto ne contengono fra 4 e 10 milioni di libri. Ma è testo di ogni qualità, e quello buono cresce di pochi punti l’anno, mentre la fame dei modelli raddoppia: Meta è passata da 15.000 miliardi di token per Llama 3 a oltre 30.000 per Llama 4 in un solo anno.
Un solo modello ne ha già letta una parte grande: Alibaba ha dichiarato di aver addestrato Qwen3 su circa 36.000 miliardi di token, più di un decimo di quella stima, l’equivalente di circa 270 milioni di libri (6). OpenAI, Google e Anthropic, che non pubblicano i loro modelli, la cifra non la dicono.
La strada più ovvia è far scrivere i dati alle macchine, e in parte succede già. Un modello grande produce gli esempi con cui se ne addestra uno più piccolo: la tecnica si chiama distillazione, ed è lecita quando chi la usa ha il permesso, ma ha un limite. Nel luglio 2024 un gruppo di ricercatori guidato da Ilia Shumailov ha mostrato su Nature che un modello addestrato di generazione in generazione su testi prodotti da altri modelli perde prima i casi rari, poi finisce per ripetere sempre le stesse cose (7). Per questo i dati scritti da persone valgono sempre di più.
E nel web sono sempre meno. Secondo Graphite, che ha analizzato 55.400 articoli in inglese con tre diversi strumenti di riconoscimento, dall’inizio del 2025 circa la metà degli articoli nuovi pubblicati in rete è scritta soprattutto dall’AI: il 49,9% nel primo trimestre del 2026 (8). Chi scava oggi nel web trova sempre più testo prodotto dalle macchine.
L’AI rischia però di prosciugare la fonte da cui beve. Il 29 ottobre l’Economist ha titolato che gli esseri umani non creeranno mai più un progetto come Wikipedia, che a 25 anni conta 30 miliardi di parole in oltre 300 lingue (9).
È un gran peccato, e i motivi li spiega la stessa Wikimedia Foundation, che gestisce l’enciclopedia. Quasi tutti i grandi modelli linguistici si addestrano su Wikipedia, ma i motori di ricerca rispondono sempre più spesso con l’AI invece di mandare i lettori sul sito, e nel 2025 le visite umane sono calate di circa l’8% rispetto all’anno prima. Con meno visite, scrive la fondazione, crescono meno volontari e meno donatori (10). Chi risponde al posto di Wikipedia esaurisce il giacimento da cui ha imparato.
Così l’estrazione si è spostata su di noi. Le aziende usano le conversazioni con i chatbot, se l’utente non spegne l’interruttore. Società come Scale AI e Mercor reclutano esperti, dai medici ai programmatori, pagati per scrivere e correggere le risposte dei modelli. Poi ci sono le licenze: secondo Reuters, Google paga a Reddit circa 60 milioni di dollari l’anno per usare i post dei suoi utenti, che di quei soldi non vedono niente (11).
Le aziende prendono anche le risposte di altri modelli, a volte di nascosto.
Secondo Anthropic, tre dei laboratori cinesi, fra cui DeepSeek, hanno passato a Claude le conversazioni dei propri utenti per usarne le risposte come materiale di addestramento, e in quelle sessioni c’erano nomi, indirizzi email, dati aziendali e altre informazioni riservate di centinaia di persone (2). Moonshot, una startup di Pechino che produce il chatbot Kimi, in dieci giorni ha girato a Claude quasi 300.000 richieste dei suoi clienti: credevano di parlare con Kimi e ricevevano le risposte di Claude, che Moonshot conservava per addestrare il suo modello. Il giacimento, così, cambia posto due volte. Anthropic, che per addestrare Claude aveva scavato il web, diventa a sua volta una miniera da cui altri estraggono. E in mezzo finiscono i dati dei clienti di Moonshot, che hanno affidato le loro domande a un’azienda e le ritrovano, senza saperlo, in mano a due.
La scala è industriale. Sempre secondo Anthropic, la campagna attribuita ad Alibaba ha raccolto oltre 151 milioni di scambi con Claude fra maggio e luglio 2026, con punte di quasi 3 milioni al giorno, da più di 3.500 account falsi. Esiste anche un mercato: alcuni intermediari, che rivendono a prezzi scontati l'accesso ai modelli americani, registrano le conversazioni degli utenti senza dirlo e le vendono ai laboratori. E una parte delle conversazioni girate a Claude veniva da utenti americani ed europei, che usavano i modelli cinesi attraverso piattaforme di smistamento comuni anche da noi. Le protezioni che impediscono a un modello di aiutare chi vuole fare danni, scrive Anthropic, non passano al modello che lo copia. Sono accuse di una parte, che nessuno ha ancora verificato.
Penso che la risposta alla quarta domanda sia questa: finito il web, i dati freschi vengono da noi, da quello che scriviamo ai chatbot e dal lavoro di chi viene pagato per insegnare alle macchine.
Che cosa stanno facendo gli Stati
La quinta domanda è che cosa stiano facendo gli Stati.
Le strade sono quattro, e si distinguono per chi deve chiedere il permesso; la tabella seguente le mette in fila. Il Giappone lascia l’addestramento libero. L’Europa lo permette finché il titolare non si oppone: in Italia basta una riserva espressa, e dal 10 ottobre 2025 ignorarla è reato (art. 171, lettera a-ter, della legge sul diritto d’autore). In Svezia STIM, la società che gestisce i diritti dei musicisti, chiede il sì dell’autore e una licenza nuova per ogni versione del modello. L’India propone una licenza obbligatoria: nessuno può dire no, ma tutti vengono pagati, anche per i modelli già addestrati. Con l’AI Act, intanto, chi sviluppa i modelli dovrà dire su quali dati li ha addestrati, entro il 2 agosto 2027 anche per quelli già sul mercato.
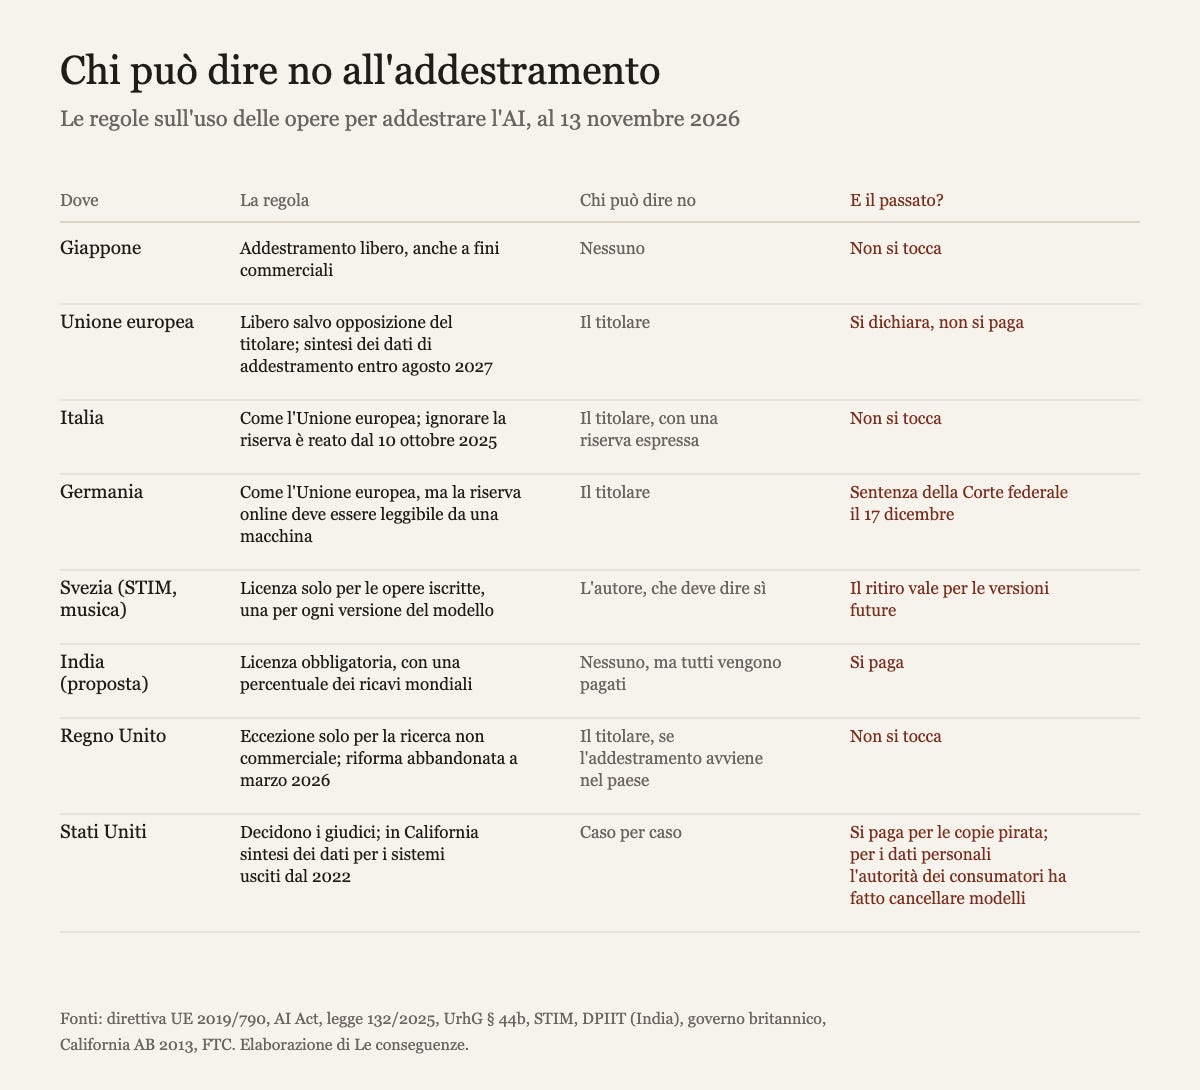
Quasi tutte queste regole valgono per i dati che verranno: chi ha già preso tutto non pagherà. Il comitato indiano lo scrive in chiaro, e per questo vuole far pagare anche il passato.
Sui due giacimenti agli estremi le regole vanno al contrario dei rischi. In Italia la legge 132 del 2025 (art. 8) permette agli enti pubblici e di ricerca di usare per l’AI i dati sanitari privati di nome e codice fiscale, senza chiedere un nuovo consenso: bastano un’informativa e una comunicazione al Garante. Il diritto europeo di tirarsene fuori arriverà solo dal 26 marzo 2029.
Per i dati di guerra una regola non c’è: l’AI Act non si applica agli usi militari e di sicurezza nazionale, e i limiti li scrivono le aziende nei contratti. Quando Anthropic non ha voluto togliere i suoi, niente armi completamente autonome e niente sorveglianza di massa dei cittadini americani, nel 2026 il Pentagono l’ha dichiarata un «rischio per la catena di fornitura».
Penso che la risposta alla quinta domanda sia questa: gli Stati regolano soprattutto i dati che verranno, e regolano meno dove i rischi sono più alti. Aggiungo che la mancanza di un coordinamento tra gli Stati rende il tutto caotico e permette agli sviluppatori di modelli di fare quello che vogliono.
Ma cosa possiamo fare noi
L’ultima domanda è che cosa possiamo fare noi, e la risposta cambia a seconda del cappello che indossiamo.
Come cittadini europei possiamo pretendere che la trasparenza del 2027 arrivi in tempo e senza deroghe: senza sapere che cosa c’è dentro un modello, nessun’altra regola si può far rispettare. Restano poi due scelte che spettano alla politica, chiedere il consenso per ogni nuova versione di un modello, come fa STIM in Svezia, e decidere se far pagare anche il passato, come propone l’India. Una terza non è ancora in agenda: una regola sui dati usati in guerra.
Chi scrive o fotografa per mestiere può dichiarare in modo espresso, sul proprio sito e nei contratti, che non autorizza l’uso delle sue opere per addestrare l’intelligenza artificiale. In Italia la riserva espressa basta, e chi la ignora commette un reato. Funziona per chi ha un sito suo. Chi pubblica su una piattaforma ha soltanto l’interruttore che la piattaforma decide di dargli.
Chi usa un chatbot può fare una cosa già questa settimana: controllare se le sue conversazioni vengono usate per l’addestramento, e disattivare l’opzione se non vuole. In ChatGPT si trova in Impostazioni, Controlli dei dati, alla voce «Migliora il modello per tutti», che nei piani personali è accesa di default; in Claude in Impostazioni, Privacy, alla voce «Aiutaci a migliorare i nostri modelli di IA». Meta AI, in Europa, non ha un interruttore: c’è soltanto un modulo per opporsi.
Chi pubblica su Substack può accendere, nella sezione Privacy delle impostazioni della sua pubblicazione, l’interruttore che chiede agli strumenti di AI di non addestrarsi sui suoi testi.
Nei romanzi bastava una testa d’aglio per tenere lontani i vampiri; in Matrix, per uscire dalla capsula, bisognava scegliere la pillola rossa. Nel nostro piccolo possiamo fare un clic nelle impostazioni: vale solo per gli addestramenti futuri, ma almeno smettiamo di rifornire gratis chi si arricchisce, e molto, contando sulla nostra ignoranza o sulla nostra distrazione.
Il resto è un lavoro più lungo, che riguarda tutti, e che è peraltro l’obiettivo principale di questo blog: spiegare al maggior numero di persone possibile che cosa sta succedendo, affinché chi ha in mano le leve della politica regoli il fenomeno e tuteli da un punto di vista giuridico ed economico anche chi la materia prima la produce.
Guido un’azienda che si occupa di automazione, agenti e intelligenza artificiale: ne scrivo perché li vedo da vicino, non per venderti qualcosa. Per questo articolo ho usato l’AI per cercare e verificare le fonti ma l’idea dell’articolo, la tesi e la revisione sono mie.
Riferimenti
1. Corte di giustizia dell’Unione europea, comunicato stampa n. 155/26, conclusioni dell’avvocato generale nella causa C-250/25, Like Company contro Google Ireland, 3 novembre 2026. link
2. Anthropic, «Detecting and countering misuse of AI: September 2026», 10 settembre 2026, sezione «Illicit distillation». link
3. TIME, Billy Perrigo, «OpenAI Used Kenyan Workers on Less Than $2 Per Hour to Make ChatGPT Less Toxic», 18 gennaio 2023. link
4. TechCrunch, «Anthropic users face a new choice: opt out or share your data for AI training», 28 agosto 2025. link
5. Epoch AI, Pablo Villalobos e altri, «Will we run out of data? Limits of LLM scaling based on human-generated data», 2024. link
6. Qwen (Alibaba), «Qwen3: Think Deeper, Act Faster», 29 aprile 2025. link
7. Ilia Shumailov e altri, «AI models collapse when trained on recursively generated data», Nature, 24 luglio 2024. link
8. Graphite, «AI now writes as many online articles as humans do», aggiornamento del 15 maggio 2026. link
9. The Economist, «Humans will never again create a project quite like Wikipedia», 29 ottobre 2026. link
10. Wikimedia Foundation, Marshall Miller, «New User Trends on Wikipedia», 17 ottobre 2025. link
11. Reuters, «Reddit in AI content licensing deal with Google», 21 febbraio 2024. link
Discussione su questo Post